Journal · 19 novembre 2026
SEO LLM : comprendre et optimiser sa présence dans les IA
Les moteurs conversationnels fondés sur des LLM (grands modèles de langage entraînés sur un large corpus textuel) ne lisent pas les pages comme Google classique. Certains puisent dans des connaissances acquises à l'entraînement, figées à une date de coupure ; d'autres interrogent le web au moment de la question. Le SEO LLM, proche du GEO (Generative Engine Optimization), repose sur ces deux mécanismes. Cet article pose le lexique, explique les deux voies d'accès aux contenus, précise quels robots laisser entrer, détaille six actions vérifiables et indique ce qu'aucune source ne garantit.
Qu'est-ce qu'un LLM et que recouvre le « SEO LLM » ?
Un lexique en un seul endroit
Quatre acronymes circulent autour du référencement LLM. Le tableau suivant les pose côte à côte pour éviter les confusions.
| Acronyme | Définition opérationnelle |
|---|---|
| LLM | Grand modèle de langage entraîné sur un large corpus textuel, capable de générer du texte en réponse à une question. |
| SEO LLM | Ensemble des pratiques visant à ce qu'un site soit repris et cité par les assistants fondés sur des LLM. |
| GEO | Optimisation pour les moteurs génératifs qui synthétisent une réponse à partir de plusieurs sources ; désigne le même champ que le SEO LLM, avec un angle moteur. |
| AEO / LLMO | Termes recouvrant partiellement la même réalité que le SEO LLM, employés selon les auteurs avec des nuances de périmètre. |
Référencement LLM : le même sujet, un autre mot
« Référencement LLM » et « SEO LLM » désignent la même démarche. Cet article traite ce qui est commun à tous les moteurs conversationnels : ChatGPT, Perplexity, Gemini, Claude, Copilot et les aperçus IA de Google. Le fonctionnement propre à chaque moteur n'est évoqué que lorsqu'il change la décision à prendre.
Comment un LLM accède-t-il aux contenus d'un site ?
Deux mécanismes gouvernent l'accès aux contenus dans le contexte du SEO LLM. Ils sont indépendants et peuvent coexister pour un même modèle selon le mode d'utilisation activé.
L'entraînement figé : une photographie datée du web
Lors de l'entraînement, les paramètres du modèle sont ajustés à partir d'un corpus collecté jusqu'à une date de coupure. Toute page publiée après cette date reste absente des connaissances internes du modèle. Une page peut figurer dans ce corpus sans être indexée par Google, et inversement.
La recherche en direct : le modèle interroge le web au moment de la réponse
D'autres systèmes pratiquent la génération augmentée par récupération (RAG) : au moment de la question, des pages ou extraits sont récupérés et fournis en contexte immédiat au modèle. ChatGPT avec navigation web, Perplexity et les aperçus IA de Google appliquent ce principe. Sur 62 réponses recueillies les 13 et 20 octobre 2026 (dix questions, trois moteurs conversationnels et l'aperçu IA de Google, via l'API du GEO Tracker), les moteurs ne citent pas tous les mêmes acteurs pour une même question.
| Dimension | Entraînement figé | Recherche en direct (RAG) |
|---|---|---|
| Accès au contenu | Données ingérées avant la date de coupure ; connaissances intégrées en mémoire | Pages récupérées au moment de la question via un moteur ou outil connecté |
| Indexation par un moteur | Non, le contenu provient du corpus collecté avant la date de coupure | Le plus souvent, car la page doit pouvoir être trouvée par l'outil de recherche du moteur |
| robots.txt pris en compte | Selon la documentation de chaque éditeur, qui publie le nom de son robot d'entraînement | Selon la documentation de chaque éditeur, qui distingue souvent un robot dédié à la recherche |
| Fraîcheur du contenu | Bloquée à la date de coupure, un fait mis à jour après peut ne pas être reflété | Contenu récent pris en compte immédiatement si la page est indexée |
| Leviers prioritaires | Cohérence de l'entité de marque ; présence dans des sources tierces de référence | Pages indexables, structurées en réponses claires ; données structurées conformes |
| Exemples de LLM | ChatGPT sans navigation, Claude sans outil web, modèles hors ligne | Perplexity, Bing Copilot, aperçus IA Google, ChatGPT avec navigation web |
Ce que ce tableau ne dit pas : dans quelle proportion chaque moteur recourt à l'un ou l'autre mécanisme pour une requête donnée. Un même modèle peut relever des deux colonnes selon le mode d'utilisation activé.
Pourquoi le SEO classique reste-t-il la base du référencement LLM ?
Une page qu'un moteur de recherche ne trouve pas a peu de chances d'être reprise par un assistant qui cherche sur le web. Les moteurs conversationnels qui fonctionnent en recherche en direct s'appuient sur un index de recherche pour trouver les pages qu'ils lisent : le travail de référencement naturel reste donc le point de départ du SEO LLM.
Ce que Google écrit noir sur blanc
Dans sa documentation sur les fonctionnalités d'IA de la recherche, consultée le 19 novembre 2026, Google pose une seule condition pour qu'une page figure comme lien dans les aperçus IA ou le mode IA : être indexée et pouvoir s'afficher dans la recherche avec un extrait. Google ajoute qu'il n'existe aucune exigence supplémentaire ni optimisation spéciale pour ces fonctionnalités.
| Prérequis de recherche classique | Effet sur le référencement LLM |
|---|---|
| Page explorable (non bloquée dans robots.txt) | Le robot du moteur peut la lire ; sinon, elle reste invisible pour la recherche en direct |
| Page indexée (pas de balise noindex) | Condition posée par Google pour les aperçus IA et le mode IA |
| Extrait autorisé (pas de nosnippet) | Google exige qu'un extrait puisse s'afficher ; nosnippet et max-snippet limitent ce qui peut être repris |
| Contenu présent dans le HTML servi | Un texte lisible sans exécution complexe est plus simple à récupérer pour tous les robots |
Ce que cela change pour un site récent
Un site jeune, peu lié depuis d'autres sites, est d'abord un site que les moteurs connaissent mal. Avant toute optimisation propre aux IA, la question à se poser est simple : la page est-elle indexée par Google et par Bing ? La Search Console de Google et les outils pour webmasters de Bing répondent page par page, gratuitement.
Quels robots des IA laisser entrer, et lesquels bloquer ?
La règle commune aux grands éditeurs est la séparation des usages : un robot sert à collecter des données d'entraînement, un autre à alimenter la recherche, un troisième à aller lire une page à la demande d'un utilisateur. Chacun se règle à part dans le fichier robots.txt, ce qui permet de refuser l'entraînement sans disparaître des réponses.
| Éditeur | Robot de recherche | Robot ou jeton d'entraînement | Lecture à la demande d'un utilisateur |
|---|---|---|---|
| Googlebot (recherche, aperçus IA, mode IA) | Google-Extended, sans effet sur la recherche selon Google | Sans objet | |
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User, pour lequel robots.txt peut ne pas s'appliquer |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot, que Perplexity dit ne pas utiliser pour l'entraînement | Aucun robot d'entraînement documenté | Perplexity-User, qui ignore en général robots.txt |
Sources : pages officielles de Google, OpenAI, Anthropic et Perplexity sur leurs robots, consultées le 19 novembre 2026. Ces listes changent : elles se relisent avant toute modification du fichier.
La décision se prend robot par robot
OpenAI précise que chaque réglage est indépendant des autres : un site peut autoriser OAI-SearchBot pour apparaître dans la recherche de ChatGPT et refuser GPTBot pour exclure ses contenus de l'entraînement. Google indique de son côté que Google-Extended n'a aucun effet sur la présence d'un site dans la recherche et n'est pas un critère de classement.
L'erreur fréquente est inverse : une règle générale « User-agent: * / Disallow: / » posée sur un site en préproduction et jamais retirée, qui ferme la porte à tous les robots de recherche à la fois. Bloquer un robot de recherche retire la page des réponses de ce moteur ; bloquer un robot d'entraînement n'a pas cet effet.
Six actions concrètes pour le référencement LLM
Les six actions suivantes reprennent les prérequis documentés plus haut. Pour chacune, la colonne de droite indique comment vérifier qu'elle est faite, sans outil payant.
| Action | Pourquoi elle compte | Comment la vérifier |
|---|---|---|
| Ouvrir l'accès aux robots de recherche | Sans accès, un moteur qui cherche en direct ne lit pas la page, quelle que soit sa qualité | Ouvrir /robots.txt et chercher une règle Disallow visant Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot ou PerplexityBot |
| Faire indexer les pages utiles | Google n'affiche dans ses aperçus IA que des pages indexées et éligibles à un extrait | Inspecter l'adresse dans la Search Console de Google et dans les outils pour webmasters de Bing |
| Structurer en réponses directes | Une section qui répond dès sa première phrase peut être reprise seule | Relire chaque intertitre et vérifier que les deux premières phrases y répondent sans lire la suite |
| Dater et sourcer les faits | Un chiffre sans date ni source ne peut pas être vérifié, ni par un lecteur ni par un moteur | Chercher dans la page chaque chiffre et contrôler qu'il porte une année et une source nommée |
| Harmoniser l'entité de marque | Des informations contradictoires d'une source à l'autre brouillent la description de l'entreprise | Comparer nom, activité, adresse et dirigeants sur le site, la fiche d'établissement Google, LinkedIn et les annuaires |
| Tenir les pages à jour | Une page obsolète peut être reprise avec une information fausse | Fixer une date de révision par page et afficher la date de mise à jour réelle |
Google précise qu'aucun balisage schema.org particulier n'est requis pour ses fonctionnalités d'IA. Les données structurées restent utiles pour décrire la page et l'entreprise sans ambiguïté, à condition d'être conformes : l'outil de test des résultats enrichis de Google signale les erreurs.
Comment rédiger un contenu extractible par les IA ?
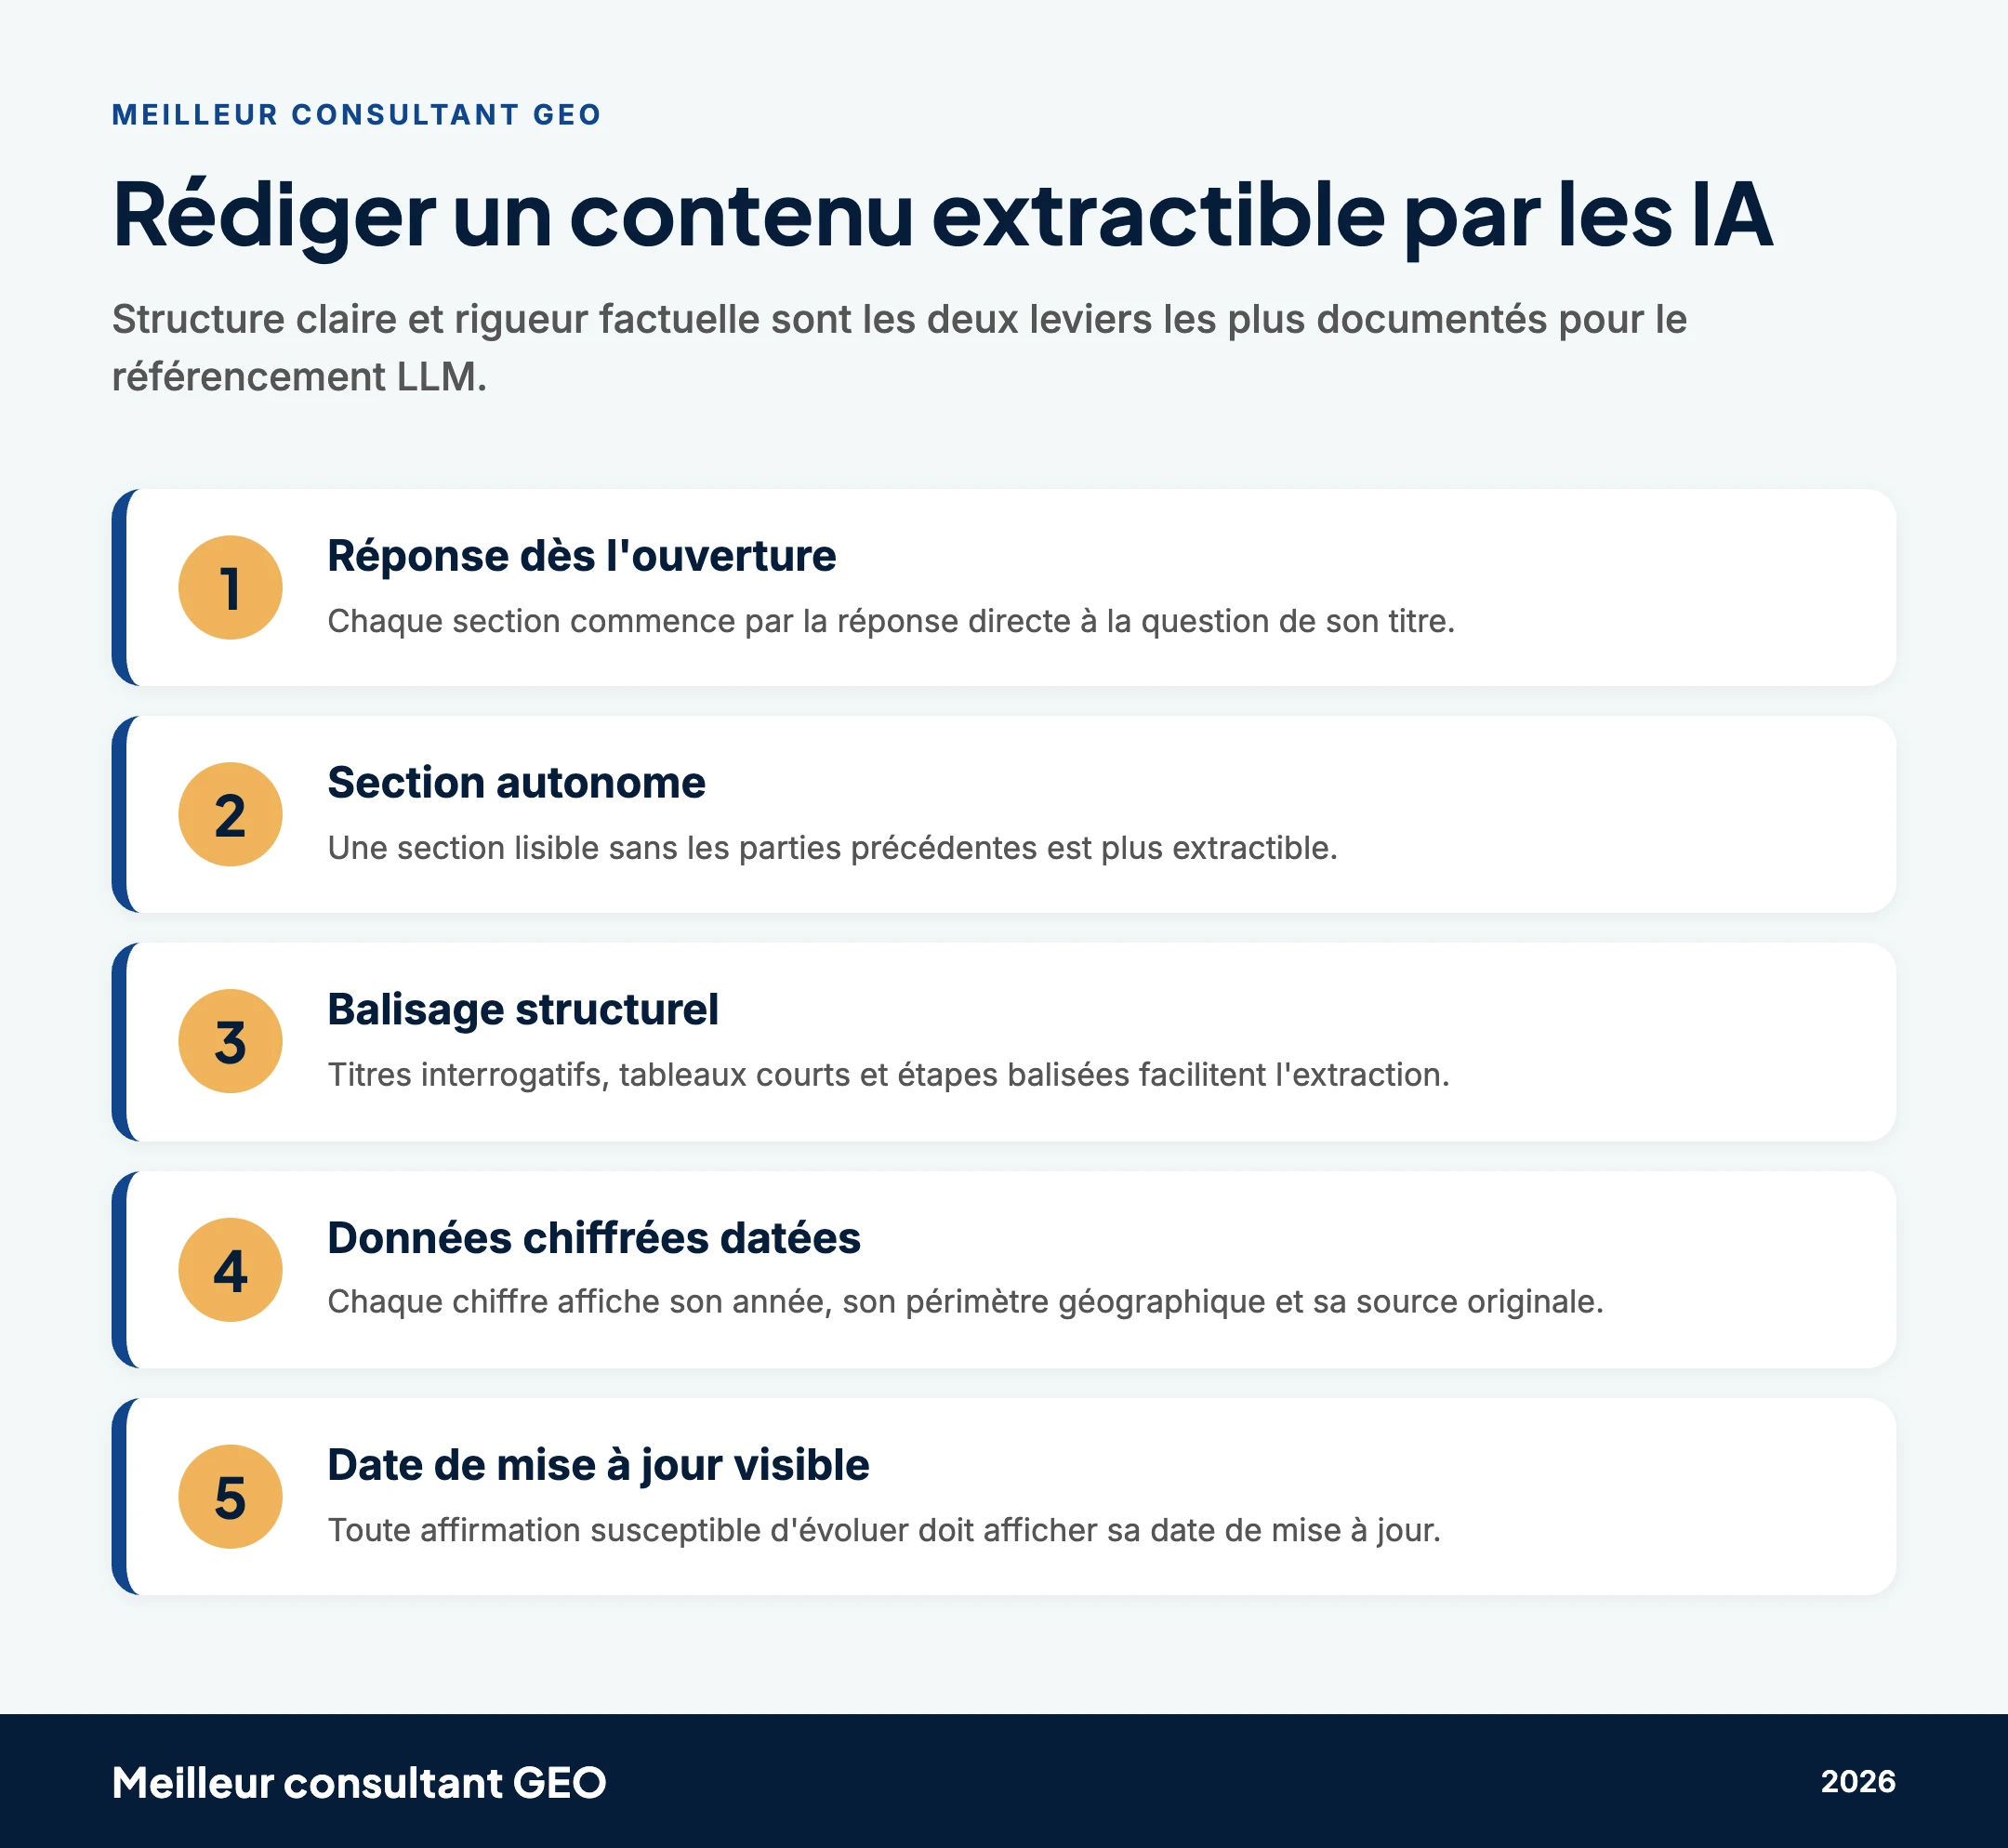
La structure d'une page et la rigueur factuelle sont les deux leviers éditoriaux les plus documentés pour faciliter l'extraction de passages dans le cadre du référencement LLM, que ce soit par entraînement ou en mode RAG.
Réponses autonomes et blocs extractibles : la règle de la section qui se tient seule
Chaque section importante doit commencer par une réponse explicite à la question posée par son titre, puis apporter contexte, preuve, date et limites. Une section qui nécessite d'avoir lu les parties précédentes pour être comprise est moins extractible par un LLM.
Les titres interrogatifs, tableaux courts, définitions et étapes balisées facilitent la lecture et l'extraction de passages. Aucune longueur précise n'est documentée comme optimale par un fournisseur de modèle de langage. Cette limite vaut d'être formulée explicitement pour éviter les recommandations chiffrées sans source.
Faits datés, sources primaires et maintenance éditoriale
Chaque donnée chiffrée gagne à afficher son année de référence, son périmètre géographique ou sectoriel, sa source originale et, si utile, la date de publication de cette source. Les affirmations susceptibles d'évoluer doivent comporter une date de mise à jour visible dans la page.
Les systèmes connectés au web peuvent prioriser des informations récentes lorsque la nature de la question l'exige. Une date de modification récente ne remplace ni la qualité du contenu ni sa pertinence. Une mise à jour artificielle sans modification substantielle n'apporte aucune garantie documentée de meilleure sélection par un LLM.
llms.txt, entité de marque et cohérence des sources tierces
Deux leviers circulent dans les discussions sur le référencement LLM sans disposer, à la date de cet article, d'une validation officielle par les acteurs concernés. Leur statut mérite d'être énoncé sans ambiguïté avant toute décision d'implémentation.
llms.txt : une proposition de format non adoptée officiellement
Le format llms.txt est une proposition de convention consistant à déposer un fichier texte à la racine d'un site pour signaler aux LLM quelles pages sont pertinentes. Le laboratoire d'innovation de la CNIL (LINC) en mentionne l'émergence dans son dossier consacré aux robots d'extraction de données.
Dans son guide « Optimizing your website for generative AI features on Google Search » (mai 2026), Google indique qu'aucun nouveau fichier lisible par machine ni fichier texte dédié à l'IA n'est nécessaire pour apparaître dans ses fonctionnalités d'IA générative. À la date de cet article, aucune documentation officielle publiée par ces fournisseurs ne décrit ce format comme un signal reconnu dans leurs systèmes de production. Statut : expérimental. L'implémenter ne nuit pas, mais aucune visibilité supplémentaire confirmée n'en découle.
Cohérence de l'entité de marque sur le site et les sources tierces
Le nom de l'entité, sa description, ses dirigeants, ses coordonnées, son activité, sa zone desservie et ses produits doivent être cohérents entre le site et les sources tierces légitimes : presse, annuaires sectoriels, Wikipedia le cas échéant.
Les mentions externes n'ont pas toutes besoin d'être liées au site pour contribuer à la désambiguïsation de l'entité. Aucun effet automatique n'est garanti par cette cohérence, et le mécanisme ne fait l'objet d'aucune documentation officielle précise à ce jour.
Ce qu'aucune source sérieuse ne garantit en matière de SEO LLM
Aucune documentation officielle consultée (Google Search Central, OpenAI, Anthropic, Perplexity) ne garantit une citation, une recommandation, un volume de trafic ou un délai après optimisation. Google indique explicitement que l'exploration, l'indexation et l'affichage d'une page ne sont pas garantis même lorsqu'elle respecte les exigences techniques publiées.
Les réponses varient selon le moteur utilisé, la formulation de la question et son contexte : lieu, langue, date, version du modèle et fonctionnalités activées. Google précise lui-même qu'AI Overviews et AI Mode peuvent recourir à des modèles et des techniques différents selon le contexte de la requête.
Le référencement LLM repose sur des prérequis vérifiables : indexabilité, performance technique, balisage conforme et structure éditoriale en réponses directes. Les décisions sur les robots d'entraînement et ceux de recherche en direct sont indépendantes et documentées. Les leviers moins formalisés, cohérence de l'entité de marque et format llms.txt, restent sans validation officielle à la date de cet article.
Aucune source officielle ne garantit une citation ou un volume de trafic après optimisation. Les résultats varient selon le moteur, la formulation et le contexte de la requête. Un site techniquement accessible, structuré en réponses claires et factuellement fiable présente les conditions les plus documentées pour être lisible par les LLM en mode RAG.
Les entreprises qui souhaitent confier cette démarche à un professionnel trouveront les profils examinés dans le classement des consultants GEO.
Questions fréquentes sur le SEO pour les LLM
Quelle est la différence entre le SEO classique et le SEO LLM ?
Le SEO classique optimise pour les moteurs d'indexation ; le seo llm vise à être cité dans les réponses des modèles génératifs.
Combien de temps faut-il pour apparaître dans les réponses d'un LLM ?
Aucun délai garanti n'est documenté. Une page récente peut être reprise par un moteur qui cherche sur le web, alors qu'un modèle figé ne la connaîtra qu'après un nouvel entraînement, sans calendrier public.
GEO et AEO désignent-ils la même chose que le SEO LLM ?
Les termes GEO et AEO (Answer Engine Optimization) désignent des démarches très proches ; les auteurs qui les distinguent rattachent le GEO aux moteurs qui synthétisent plusieurs sources et l'AEO aux réponses directes, sans définition officielle commune.
Faut-il créer un fichier llms.txt pour optimiser sa présence dans les IA ?
Ce n'est pas nécessaire pour Google, qui précise qu'aucun nouveau fichier n'est requis pour ses fonctionnalités d'IA. Le format reste une proposition expérimentale.
Les robots de ChatGPT, Perplexity et Google fonctionnent-ils de la même façon ?
Non. Chaque éditeur publie le nom de ses robots et la manière de les autoriser ou de les bloquer dans le fichier robots.txt ; la décision se prend robot par robot.
Comment vérifier si un LLM utilise les pages de son site pour répondre ?
Interroger le modèle avec des formulations issues du site et noter les citations reste la méthode directe. Aucun outil officiel de vérification n'est documenté.
Sources
- Google Search Central, « Optimizing your website for generative AI features on Google Search », mai 2026
- Google Search Central, « AI features and your website » et « Google's common crawlers », consultés le 19 novembre 2026
- OpenAI, « Overview of OpenAI Crawlers », consulté le 19 novembre 2026
- Anthropic, centre d'aide Claude, page sur l'exploration du web et le blocage des robots, consultée le 19 novembre 2026
- Perplexity, « Perplexity Crawlers », consulté le 19 novembre 2026
- CNIL, laboratoire LINC, dossier « Comment empêcher les robots d'extraction de données de collecter des données publiquement accessibles »
Billet de Inès Charpy, établi à partir de faits publics datés. Une erreur à signaler : page contact.