Journal · 21 octobre 2026
Visibilité IA : comment apparaître dans les réponses de ChatGPT, Perplexity et Gemini
Apparaître dans les réponses de ChatGPT, de Perplexity, de Gemini ou des aperçus IA de Google n'est pas un label qu'on obtient : c'est le résultat de conditions techniques et éditoriales, que l'on peut vérifier une à une. Cette page les passe en revue, dans l'ordre où il est logique de les traiter, avec pour chacune l'action à mener et la façon de la contrôler sans outil payant.
GEO et visibilité IA : comment les moteurs génératifs sélectionnent leurs sources
Avant de formuler une réponse, un moteur génératif ne raisonne pas sur l'ensemble du web. Il récupère d'abord un ensemble de passages pertinents, les évalue, puis synthétise. Comprendre ce mécanisme explique pourquoi certaines pages sont citées et d'autres ignorées.
Retrieval-augmented generation : le mécanisme derrière la citation
Le GEO (Generative Engine Optimization) désigne la discipline qui vise à optimiser la présence d'une marque ou d'une organisation dans les réponses des moteurs génératifs. Il prolonge le SEO classique sans le remplacer : les fondations, indexabilité, contenu de qualité, autorité de domaine, restent identiques. Ce qui s'y ajoute, ce sont des exigences propres : clarté de l'entité, passages directement extractibles, présence sur des sources tierces reconnues.
L'architecture sous-jacente s'appelle RAG (retrieval-augmented generation). Avant de rédiger une réponse, le moteur exécute une phase de récupération : il interroge un index ou le web en temps réel et sélectionne des passages pertinents. Ces passages servent de contexte à la génération de la réponse. C'est ce mécanisme de sélection, documenté par OpenAI dans ses ressources pour développeurs et par Google Search Central pour les aperçus IA, qui détermine quelles sources sont citées.
Une page absente de l'index ou inaccessible aux robots d'exploration ne peut pas être récupérée lors de cette phase. Elle n'existe pas pour le moteur, quel que soit son contenu.
Spécificités de ChatGPT, Perplexity, Gemini et des aperçus IA de Google
Chaque moteur accède au web selon des règles distinctes. La différence porte sur la fraîcheur des données, le robot utilisé et la base d'index mobilisée. Ces distinctions ont des conséquences directes sur les actions à prioriser.
| Moteur | Accès au web | Robot(s) documenté(s) | Base d'index |
|---|---|---|---|
| ChatGPT (navigation activée) | Recherche web en temps réel | OAI-SearchBot, ChatGPT-User | Non détaillée par OpenAI |
| ChatGPT (sans navigation) | Aucun accès web en temps réel | GPTBot (entraînement) | Données d'entraînement, date limite fixe |
| Perplexity | Recherche web en temps réel à chaque requête | PerplexityBot | Non détaillée par Perplexity |
| Gemini | Recherche via l'index Google | Google-Extended (entraînement), Googlebot | Index Google |
| Aperçus IA de Google (AI Overviews) | Index Google existant | Googlebot | Index Google |
Sources : pages d'aide OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User), documentation Perplexity (PerplexityBot), Google Search Central (Google-Extended, Googlebot), consultées en octobre 2026.
La distinction entre robot d'entraînement et robot d'affichage est capitale. Le premier collecte des données pour construire ou affiner le modèle ; le second récupère des pages pour générer des réponses en temps réel. Bloquer le robot d'affichage suffit à s'exclure des réponses actuelles, même si le robot d'entraînement a déjà parcouru le site lors d'une phase antérieure. Les deux usages nécessitent des décisions séparées dans robots.txt.
Accès des robots : robots.txt et indexabilité, premières conditions de la visibilité IA
Une page non accessible aux robots d'exploration ne sera jamais citée. C'est la condition la plus élémentaire et souvent la plus négligée. La vérification prend moins de dix minutes et ne nécessite aucun abonnement.
Robots officiels des moteurs génératifs et règles d'accès dans robots.txt
Chaque moteur génératif dispose d'identifiants officiels (user-agents) documentés dans ses ressources d'aide. Le fichier robots.txt d'un site doit les autoriser sur les pages à citer. Un fichier qui contient une règle Disallow: / générale bloque indifféremment les robots de recherche classiques et ceux des moteurs IA.
| Moteur | Robot d'entraînement | Robot d'affichage (réponses en temps réel) |
|---|---|---|
| OpenAI / ChatGPT | GPTBot | OAI-SearchBot, ChatGPT-User |
| Perplexity | PerplexityBot | PerplexityBot |
| Google (IA générative, Gemini) | Google-Extended | Googlebot |
| Google (aperçus IA) | , | Googlebot |
Sources : pages d'aide OpenAI, documentation Perplexity, Google Search Central, octobre 2026.
Action concrète : ouvrir le fichier robots.txt du domaine (mondomaine.com/robots.txt) et vérifier que les robots d'affichage listés ci-dessus ne font l'objet d'aucune règle Disallow. Si une règle globale bloque tous les agents, ajouter des règles d'autorisation spécifiques pour chaque robot d'affichage.
Un point souvent négligé : bloquer Google-Extended, destiné à l'entraînement de Gemini, n'empêche pas Googlebot d'accéder à la page. Les aperçus IA de Google s'appuient sur Googlebot, pas sur Google-Extended. Ces deux robots ont des fonctions distinctes ; une décision de blocage doit les distinguer.
Vérifier l'indexabilité des pages sans outil payant
L'indexabilité d'une page repose sur quatre conditions cumulatives : réponse HTTP 200, absence de balise noindex dans l'en-tête ou la balise meta, URL canonique pointant vers la page elle-même, aucun blocage dans robots.txt. Une seule condition non remplie suffit à exclure la page de l'index.
La vérification la plus rapide passe par Google Search Console. L'outil « Inspection d'URL » indique si la page est indexée, si elle est bloquée par robots.txt ou par une balise noindex, et quel résultat a renvoyé le dernier crawl. La commande site:mondomaine.com dans Google complète ce diagnostic : si les pages importantes n'y apparaissent pas, elles sont absentes de l'index.
Un sitemap XML à jour, déclaré dans robots.txt et soumis dans Search Console, accélère la découverte des pages nouvelles ou modifiées. Signal visé : chaque page à forte intention de requête renvoie un statut « indexée » dans Search Console.
| Condition | Vérification gratuite |
|---|---|
| Réponse HTTP 200 | Inspection d'URL dans Google Search Console |
| Balise noindex absente | Affichage source de la page (Ctrl+U), recherche « noindex » |
| Canonique correcte | Affichage source, recherche « canonical » |
| Aucun blocage robots.txt | Outil de test robots.txt dans Search Console |
Ces quatre vérifications ne nécessitent aucun abonnement. Elles constituent le socle minimal avant toute action éditoriale.
Contenu extractible : structurer les pages pour répondre directement à la question
Un moteur génératif ne lit pas une page de la même façon qu'un lecteur humain. Il recherche un passage court, autonome, qui répond directement à la requête formulée. Si ce passage n'existe pas ou se trouve en milieu de page, la probabilité d'extraction baisse.
Répondre en tête de section : la règle du passage direct
Google Search Central documente le passage indexing : le moteur est capable d'indexer un passage précis d'une page, distinct du sujet général de la page. Ce mécanisme s'applique également aux aperçus IA. Un passage placé en tête de section, formulant directement la réponse à la question posée par le titre H2, est le plus facile à extraire.
La recommandation pratique : les deux premières phrases de chaque section doivent contenir la réponse complète. Le développement, les nuances et les exemples viennent ensuite. Une page dont chaque section commence par un contexte préliminaire avant d'arriver à la réponse rend l'extraction plus difficile pour un modèle qui cherche un passage autonome.
La cohérence entre le titre de section et la réponse immédiatement placée sous ce titre renforce l'extractibilité. Un H2 formulé comme une question appelle une réponse directe dans le premier paragraphe. Cette cohérence est lisible par un indexeur automatique, indépendamment du reste du contenu.
Action : relire les 150 premiers mots de chaque page prioritaire. Si ces 150 mots ne contiennent pas une réponse complète et autonome à la question visée, reformater la section. La vérification est manuelle, sans outil.
Faits datés, auteur identifié et hiérarchie sémantique claire
Les moteurs génératifs s'appuient sur plusieurs signaux pour qualifier la fiabilité d'un contenu : la date, l'identité de l'auteur et la cohérence de la structure. Ces signaux réduisent l'ambiguïté lors de la phase de récupération.
La date de publication et la date de révision doivent être visibles en haut de page. Un contenu non daté ou dont la date est reléguée dans le pied de page est plus difficile à qualifier par un modèle qui cherche des informations récentes. Un contenu récent et daté est plus simple à situer pour un moteur qui cherche des informations à jour.
L'auteur doit être nommé, prénom, nom, fonction, avec un lien vers une page auteur contenant une courte biographie. Cette page auteur relie les contenus publiés à une entité identifiable. Google présente l'identification de l'auteur parmi les signaux de confiance de ses consignes de qualité (E-E-A-T).
| Élément | Action | Vérification |
|---|---|---|
| Date de publication et révision | Afficher en tête de page, mettre à jour à chaque modification significative | Lecture visuelle de la page |
| Page auteur | Créer une page par auteur avec biographie courte et lien depuis chaque article | Vérifier que le lien auteur est présent sur chaque page publiée |
| Hiérarchie H1-H2-H3 | Structurer sans saut de niveau (pas de H3 sans H2 parent, un seul H1) | Affichage source, contrôle de la structure des titres |
| Sources nommées dans le corps du texte | Citer l'organisme, le titre et l'année à chaque donnée factuelle | Lecture manuelle de chaque passage chiffré |
Cohérence de l'entité : pourquoi un nom ou un sigle ambigu fait citer d'autres acteurs
Un moteur génératif ne cherche pas une URL : il cherche une entité. Si cette entité porte un nom partagé avec un autre domaine ou un autre secteur, la confusion est mécanique. Cette section décrit le principe de désambiguïsation et les actions concrètes pour y remédier.
Désambiguïsation : même nom, mêmes informations sur toutes les plateformes
La désambiguïsation consiste à distinguer clairement une marque ou une organisation de toute autre entité portant un nom, un sigle ou une abréviation proche. Un moteur génératif associe un nom à un ensemble de signaux convergents : site web, fiche Wikidata, LinkedIn, Google Business Profile, annuaires sectoriels. Si ces signaux divergent, nom formulé différemment selon la plateforme, sigle non explicité, description absente sur l'une d'elles, le modèle peut confondre l'entité avec une autre.
Le relevé des 13 et 20 octobre 2026 fournit un exemple concret de ce risque. Sur 62 réponses recueillies auprès de trois moteurs génératifs et de l'aperçu IA de Google à partir de 10 questions portant sur un même secteur, 14 réponses ont cité des acteurs sans rapport avec ce secteur. Ces réponses erronées provenaient de ChatGPT (6) et de Gemini (8) ; Perplexity n'en enregistrait aucune lors de ce relevé. La cause probable : un sigle partagé avec le domaine de la géomatique, que les moteurs ont lu dans son autre sens.
Ce que ce relevé ne dit pas : il ne permet pas de conclure que Perplexity désambiguïse mieux dans tous les cas. La différence peut s'expliquer par la méthode d'accès au web propre à chaque moteur, par le corpus de pages consultées au moment du relevé, ou par la formulation des 10 questions. Un relevé ponctuel ne suffit pas à généraliser.
Les actions de désambiguïsation suivent une logique de normalisation : utiliser exactement le même nom sur chaque plateforme, expliciter les sigles dès leur première occurrence dans chaque contenu, créer ou compléter une fiche Wikidata, vérifier la cohérence sur Google Business Profile et dans les annuaires sectoriels.
| Action | Signal visé | Vérification |
|---|---|---|
| Uniformiser le nom exact sur site, LinkedIn, Google Business Profile et annuaires | Entité désambiguïsée | Recherche du nom sur chaque plateforme, comparaison manuelle |
| Expliciter les sigles à chaque première occurrence dans le contenu | Sigle non ambigu | Lecture des pages prioritaires, recherche du sigle seul |
| Créer ou compléter une fiche Wikidata | Identifiant unique de l'entité | Recherche du nom de la marque sur wikidata.org |
| Poser un prompt de test dans les trois moteurs | Description renvoyée correspondant au secteur réel | Saisir « qui est [nom de la marque] ? » dans ChatGPT, Perplexity et Gemini |
Le prompt de test est la méthode de vérification la plus rapide. Si la réponse renvoyée décrit un autre secteur, un autre domaine ou une entité distincte, la désambiguïsation n'est pas encore effective. Une capture d'écran datée permet de comparer les résultats d'une vague à l'autre, sans aucun outil supplémentaire.
Données structurées et fraîcheur : deux compléments, pas des conditions
Aucun des trois moteurs ne présente les données structurées comme une condition de citation. Leur intérêt est de lever l'ambiguïté : un balisage Organization (nom, site, profils officiels) ou Article (auteur, date) dit explicitement de quelle entité et de quel contenu il s'agit. Le test des résultats enrichis de Google permet de contrôler gratuitement que le balisage est valide.
La fraîcheur joue de la même façon : une page dont la date de révision est visible et à jour se situe plus facilement dans le temps. Réviser les pages prioritaires à chaque changement de fait (prix, offre, équipe) vaut mieux qu'une mise à jour cosmétique, et le plus simple est de dater chaque révision en tête de page.
Sources tierces : presse, annuaires et comparatifs que les moteurs reprennent
Les moteurs génératifs, ChatGPT (OpenAI), Perplexity et Gemini (Google DeepMind), n'extraient pas uniquement les pages du site d'une marque. Ils pondèrent les entités selon la convergence de sources indépendantes qui mentionnent les mêmes faits. Cette logique de corroboration est l'une des conditions de la visibilité IA d'une organisation.
Quelles sources tierces renforcent la corroboration d'une marque
Six catégories de sources tierces sont régulièrement indexées et reprises par les moteurs génératifs : la presse professionnelle et grand public, les annuaires sectoriels reconnus, les avis en ligne vérifiés (Google Business Profile, Trustpilot), les listes comparatives et guides d'achat, les fiches Wikidata et Wikipedia, les profils LinkedIn d'organisation. Un moteur qui retrouve les mêmes faits sur plusieurs sources crédibles et indépendantes attribue davantage de poids à l'entité concernée.
Aucune statistique officielle française ne mesure le taux de citation des marques dans ces moteurs (sources consultées, octobre 2026). L'action de départ reste dans tous les cas la même : saisir le nom exact de la marque dans Google, lister les sources existantes, identifier les catégories manquantes.
| Catégorie de source | Rôle dans la corroboration | Action concrète | Vérification sans outil payant |
|---|---|---|---|
| Presse professionnelle et grand public | Crédibilité éditoriale ; sources fréquemment présentes dans les index repris par les moteurs | Proposer une tribune ou une interview à un média du secteur ; communiquer sur un fait notable et daté | Chercher [nom de marque] dans Google Actualités et noter les médias qui la citent |
| Annuaires sectoriels reconnus | Signal de catégorisation : le modèle peut associer l'entité à un secteur précis | S'inscrire dans deux ou trois annuaires reconnus du secteur (vérifier qu'ils apparaissent eux-mêmes dans les résultats Google) | Chercher [nom de marque] site:nomdelannuaire.fr dans Google |
| Avis en ligne vérifiés (Google Business Profile, Trustpilot) | Preuve d'existence et d'activité réelle ; répétition du nom exact sur des sources à fort trafic | Compléter et tenir à jour la fiche Google Business Profile ; inviter les clients à laisser un avis daté | Chercher le nom de la marque dans Google Maps et sur Trustpilot |
| Listes comparatives et guides d'achat | Association de la marque à une catégorie de produit ou de service précise, dans un contexte de sélection | Contacter les auteurs de comparatifs existants pour signaler la marque ; proposer des données vérifiables à jour | Chercher [catégorie de produit] comparatif dans Google et relever les listes où la marque est absente |
| Fiche Wikidata (et Wikipedia si éligible) | Identifiant unique de l'entité ; données structurées ouvertes et réutilisables | Créer ou compléter la fiche Wikidata avec les champs standards (nom, secteur, site, date de création) | Chercher le nom de la marque sur wikidata.org |
| Profil LinkedIn d'organisation | Source régulièrement indexée ; cohérence du nom et du secteur sur une plateforme à fort trafic | Vérifier que le nom, le secteur et la description correspondent exactement à ceux du site et des annuaires | Chercher [nom de marque] site:linkedin.com dans Google |
Ce que ce relevé ne dit pas : la présence sur ces six catégories de sources ne garantit pas d'apparaître dans les réponses générées. Les moteurs ne publient pas leurs critères de sélection des sources. Un annuaire sans autorité propre n'apporte rien. Seul un relevé régulier des réponses dans les trois moteurs permet de constater un éventuel effet des actions engagées.
Prompts de test : comment formuler une vérification sans outil payant
Trois types de prompts permettent une vérification directe dans ChatGPT (OpenAI), Perplexity et Gemini (Google). Aucun abonnement payant n'est requis pour leurs versions de base, disponibles depuis la France.
La question directe sur la marque est la plus rapide à interpréter. Formulation : « Qui est [nom de marque] ? » ou « Que fait [nom de marque] ? ». La réponse attendue décrit le secteur d'activité réel, mentionne le nom correct et ne confond pas la marque avec une entité homonyme. Une description erronée signale un problème de désambiguïsation, traité dans la section consacrée à la cohérence de l'entité.
La question sectorielle, par exemple « Quels sont les cabinets spécialisés en [secteur précis] en France ? », teste l'association de la marque à sa catégorie. La question de recommandation, formulation la plus proche d'une intention d'achat, donne des résultats encore plus variables : une même requête posée deux fois dans la même session peut produire des listes différentes.
Pour ces deux derniers types, une absence de citation ne suffit pas à conclure. Les résultats varient selon la session, la date du relevé et l'interface utilisée. Ce facteur de variabilité est documenté dans les descriptions techniques des modèles.
Méthode commune d'interprétation : noter si la citation est directe (nom mentionné), indirecte (description qui correspond sans nommer), erronée ou absente. Sauvegarder la capture d'écran avec la date. Un relevé mensuel suffit pour détecter une évolution sur la durée.
Ce que ces actions ne garantissent pas : limites documentées
Aucun éditeur de moteur génératif ne publie de critères de citation garantis. ChatGPT (OpenAI), Perplexity et Google n'ont pas documenté de mécanisme permettant à une marque d'obtenir une citation assurée dans leurs réponses.
Aucune statistique officielle ne mesure le taux de citation des marques dans ChatGPT, Perplexity, Gemini ou les aperçus IA de Google. Les délais entre une modification du site et une première citation ne sont pas documentés par les éditeurs. Une page indexée par Google n'est pas automatiquement reprise dans les aperçus IA.
Plusieurs pratiques circulent sans base documentaire vérifiable : prétendre soumettre des informations « directement » à l'IA, acheter des emplacements dans des réponses générées, ou « faire reconnaître sa marque par les IA » via un service tiers. Aucune de ces pratiques ne repose sur une documentation officielle publiée par les éditeurs des moteurs concernés.
Les résultats varient selon la session, le pays et l'interface. Un relevé effectué depuis la France en français peut différer d'un relevé effectué depuis la Belgique ou en anglais. Ce facteur est documenté dans les descriptions techniques des modèles, sans que les éditeurs ne publient de données de dispersion standardisées.
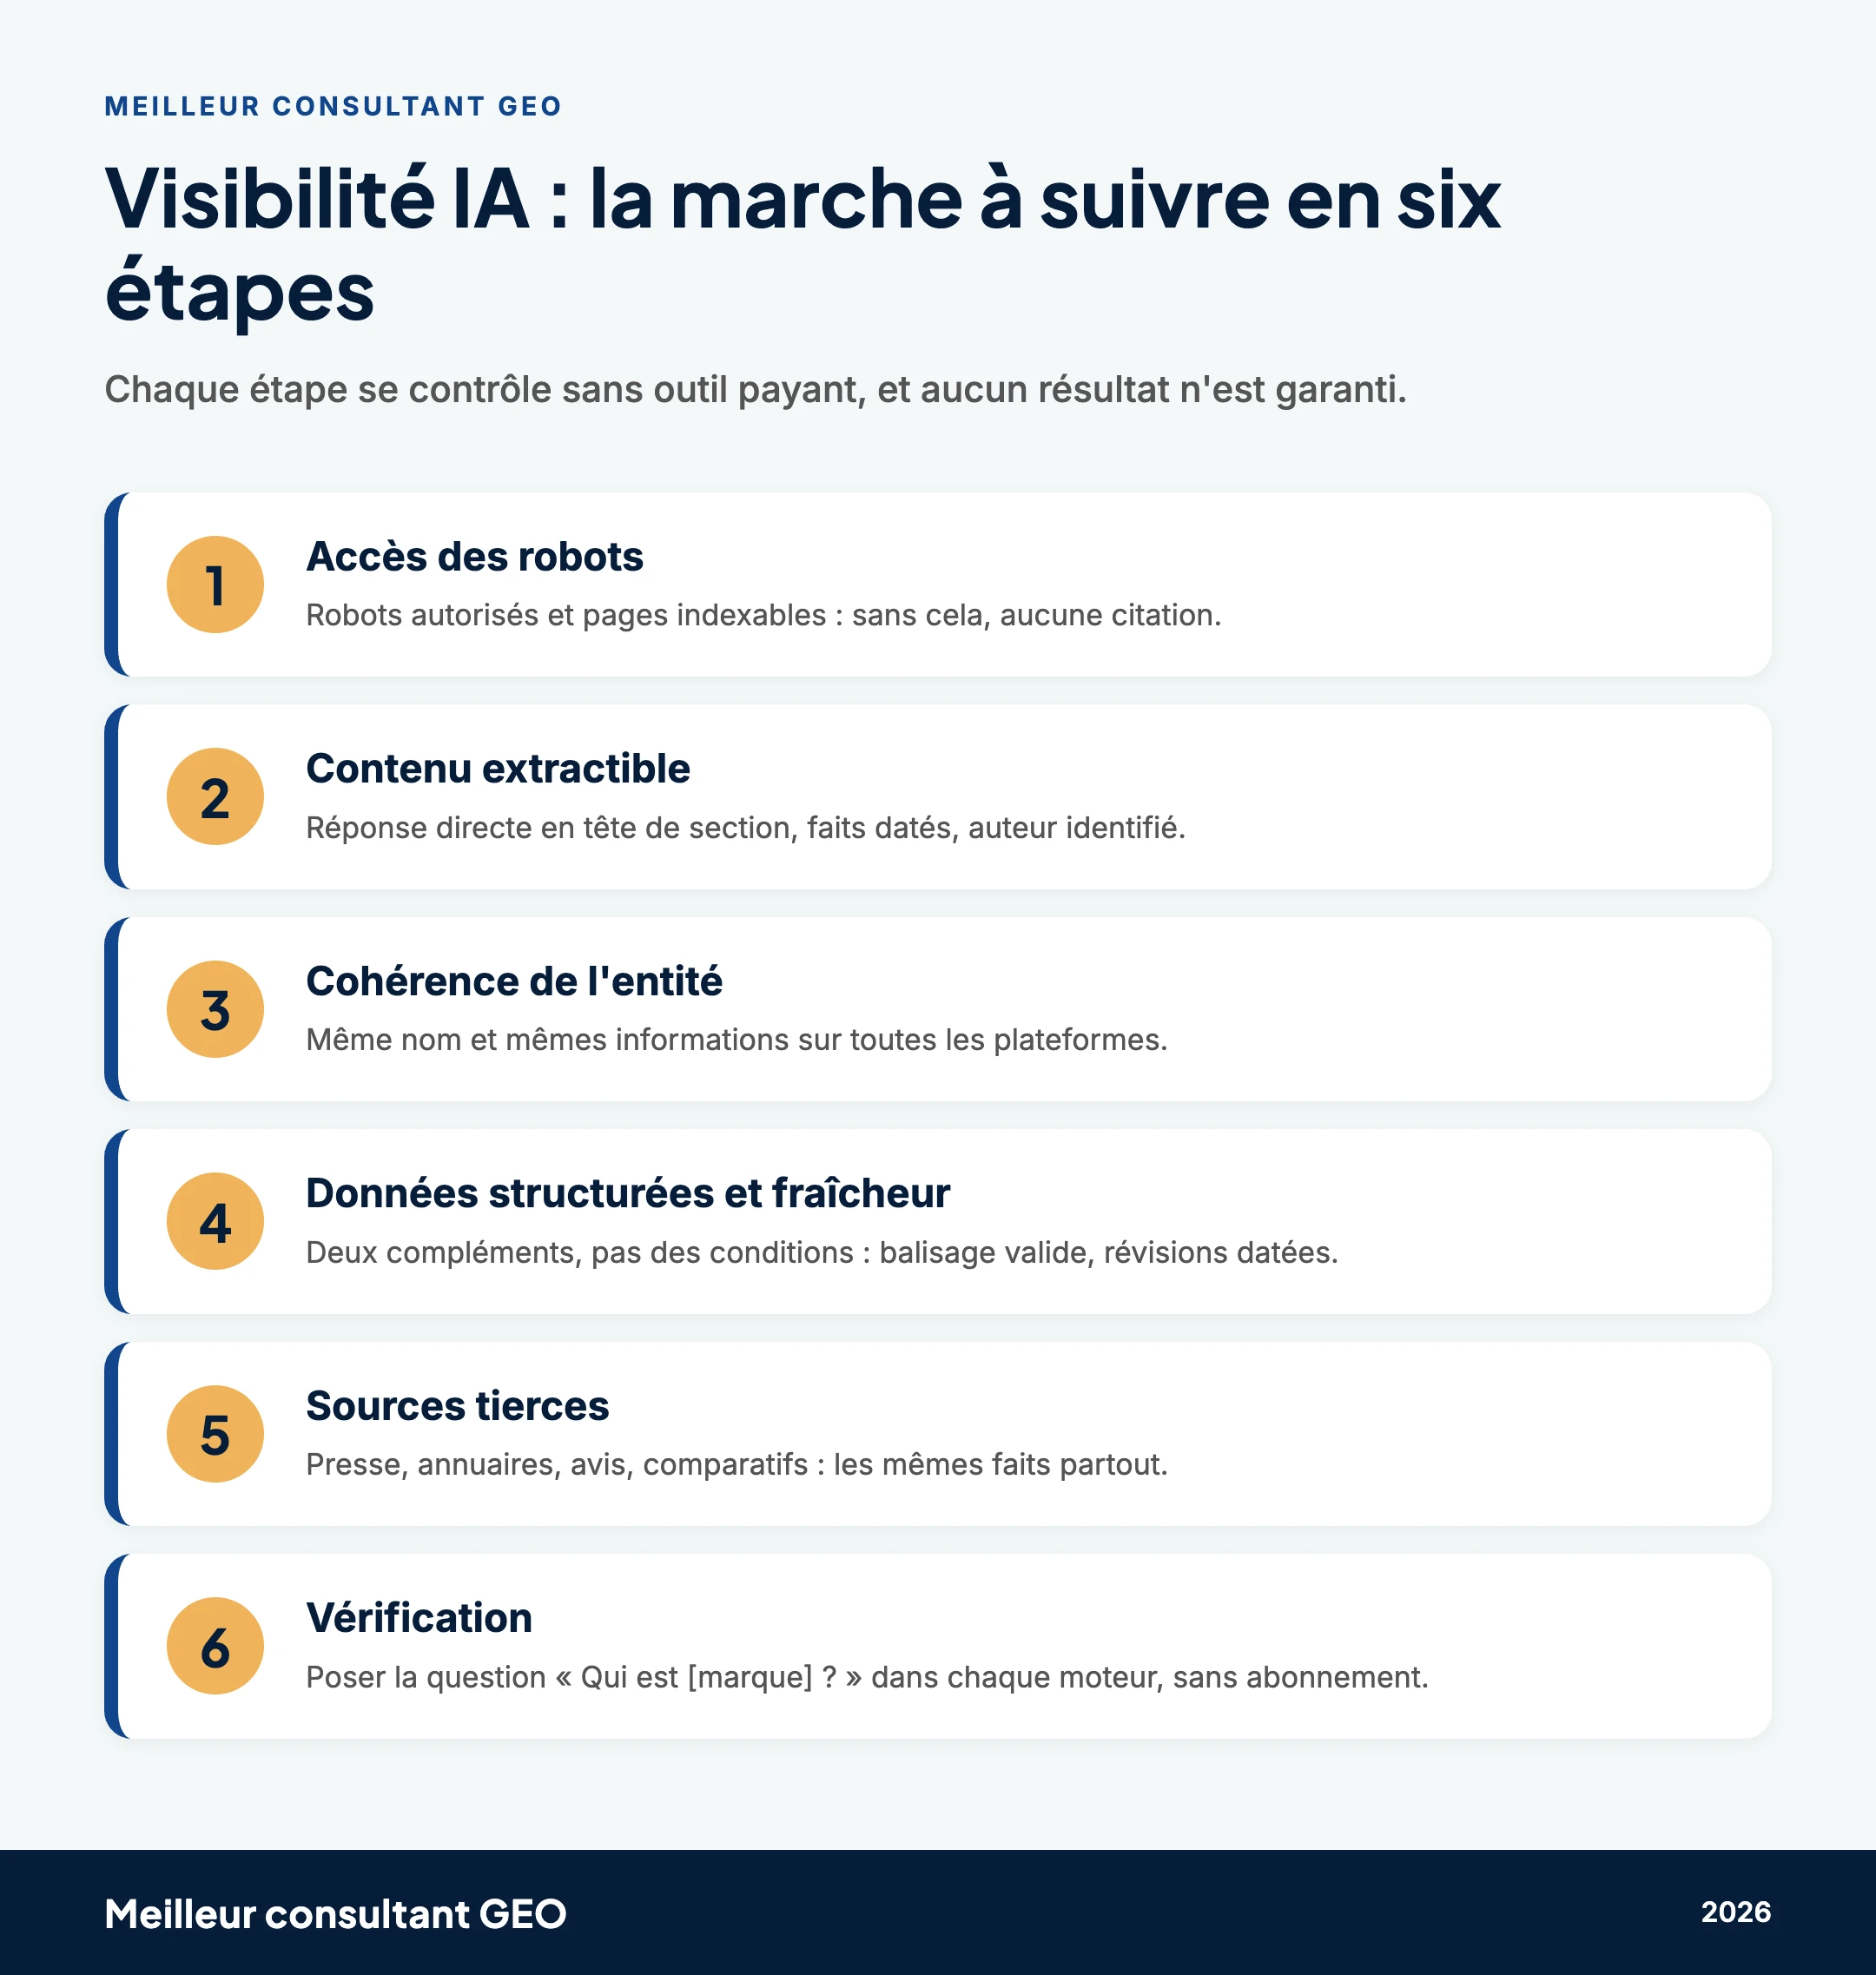
Les actions décrites dans cet article se conduisent sans outil payant et dans un ordre défini : accès des robots et indexabilité d'abord, contenu extractible, cohérence de l'entité, sources tierces, puis relevé régulier. Chacune est vérifiable avec Google Search Console et les interfaces gratuites des trois moteurs.
Le classement des consultants GEO actifs en France, avec les relevés de citation datés, est accessible sur la page de classement de meilleur-consultant-geo.com.
Questions fréquentes sur la visibilité dans les moteurs génératifs
Combien de temps faut-il pour qu'une marque apparaisse dans les réponses d'un moteur génératif ?
Aucune statistique officielle ne mesure ce délai. Les moteurs génératifs ne publient pas de calendrier d'indexation des sources, et aucune garantie d'apparition n'existe.
Le SEO classique suffit-il pour obtenir une visibilité IA ?
Le SEO classique constitue une base nécessaire mais insuffisante. Le GEO (Generative Engine Optimization) ajoute des signaux spécifiques, désambiguïsation d'entité, données structurées, contenu extractible, que les moteurs génératifs exploitent différemment des moteurs de recherche traditionnels.
Faut-il un abonnement payant sur ChatGPT ou Perplexity pour être cité dans leurs réponses ?
Non. Le statut d'abonné concerne l'accès aux fonctionnalités pour l'utilisateur, pas la sélection des sources citées dans les réponses générées.
Peut-on soumettre ses informations directement à ChatGPT, Perplexity ou Gemini ?
Aucun de ces trois moteurs ne propose de mécanisme de soumission directe comparable au Search Console de Google.
Quels schémas Schema.org sont les plus utiles pour améliorer la visibilité IA ?
Les schémas Organization, FAQPage et Article facilitent la désambiguïsation d'entité et l'extraction de réponses. Leur présence est vérifiable gratuitement via le validateur officiel schema.org.
Une page sans trafic organique peut-elle apparaître dans les réponses d'une IA générative ?
Techniquement oui, si la page est indexable et citée par des sources tierces reconnues. Le trafic organique n'est pas un critère déclaré par les moteurs génératifs pour la sélection des sources.
Billet de Inès Charpy, établi à partir de faits publics datés. Une erreur à signaler : page contact.